Economizar tokens no Codex e Copilot
Equipe Skillpedia · atualizado em 16/10/2026 · 9 min de leitura
Resposta curta: Tokens são como moedas que você gasta toda vez que usa uma IA para programar. Para economizar tokens no Codex e Copilot, pense em ser direto e claro com a IA, como se desse instruções a um amigo novato. Isso faz seu "dinheiro" de tokens render mais.
Você já pediu ajuda a uma pessoa e ela respondeu com um texto enorme e confuso? Às vezes, ao usar ferramentas de IA para programar, como o Codex ou o Copilot, acontece algo parecido. A IA pode gerar respostas longas e complexas que consomem muitos "tokens". Se você é novo nisso e quer entender como economizar esse recurso, veio ao lugar certo. Vamos explicar tudo de forma simples, como numa conversa entre amigos.
Índice
- O que são tokens e por que preciso economizar?
- Codex e Copilot: seus ajudantes de código
- Como ser um "chefe" claro para a IA
- Dicas práticas para economizar tokens no dia a dia
- Erros comuns que desperdiçam seus tokens
- Recomendamos testar estas 3 skills primeiro
- Perguntas frequentes
O que são tokens e por que preciso economizar?
Pense nos tokens como as "palavras" ou "blocos de letras" que a IA consegue enxergar. Tudo que você digita e tudo que a IA responde é contado em tokens. É como se cada conversa custasse um pouco da sua "ficha" ou "crédito". Se você entender O que são tokens em IA (e por que eles acabam tão rápido), verá que eles são o combustível da conversa.
Um servidor é um computador superpoderoso, longe de você, que processa os pedidos da IA. É como a cozinha de um restaurante: você faz o pedido (sua pergunta) no salão (seu computador), e a cozinha (o servidor) prepara a comida (a resposta).
Por que economizar? Porque os planos de uso dessas ferramentas têm limites baseados em tokens. Usar muitos tokens de uma vez pode fazer seu limite acabar rápido ou tornar as respostas mais lentas e caras. Economizar é fazer render mais, fazer perguntas melhores e obter código mais útil.
Codex e Copilot: seus ajudantes de código
Vamos conhecer os "personagens" principais:
- Codex: É uma IA especializada em entender e escrever código. Pense nela como um assistente experiente que olha para o que você está tentando fazer e sugere pedaços de código completos.
- Copilot: É uma ferramenta que usa o Codex (ou modelos similares) diretamente no seu editor de programação, como o VS Code. É como ter o assistente experiente sentado ao seu lado, dando sugestões em tempo real enquanto você digita.
Um repositório é uma pasta especial no seu computador ou na internet onde você guarda todos os arquivos de um projeto. É como uma caixa organizadora com etiquetas para você achar tudo facilmente.
A API é a forma como dois programas conversam entre si. Imagine que você precise de dados do clima: seu app pergunta para o serviço de meteorologia através de uma "linha telefônica" padrão (a API), e ele responde. No nosso caso, seu editor de código (como o VS Code) conversa com a IA do Copilot através de uma API.
Como ser um "chefe" claro para a IA
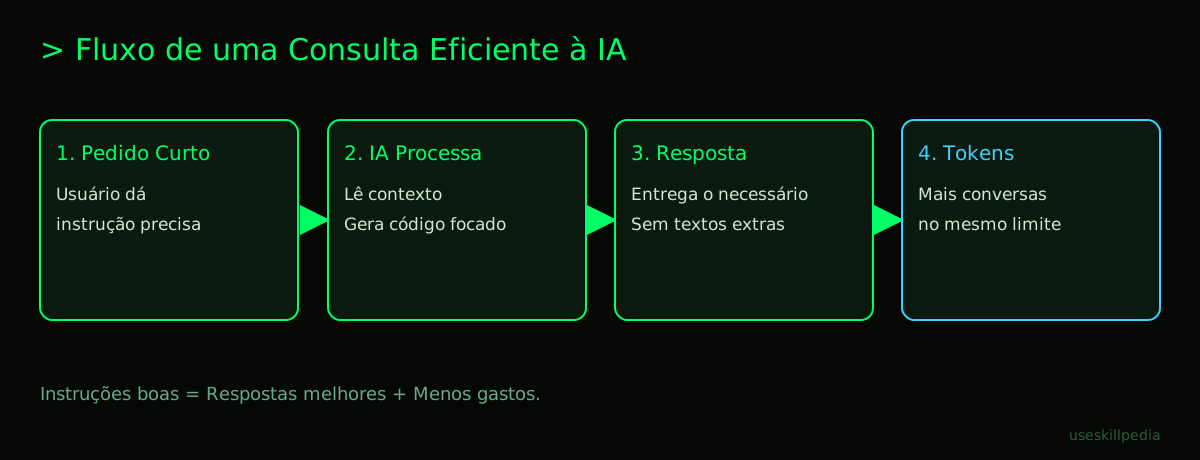
Para a IA entender bem e gastar poucos tokens, você precisa dar instruções claras. Imagine que você é o chefe e a IA é um estagiário muito inteligente, mas que precisa de orientações precisas.
- Seja específico: Em vez de "crie um botão", diga "crie um botão vermelho, com o texto 'Salvar', que quando clicado mostra um alerta dizendo 'Dados salvos'". Quanto mais contexto relevante você der de uma vez, menos a IA precisa adivinhar.
- Dê exemplos: Mostre à IA o formato que você quer. É como ensinar alguém a fazer um bolo mostrando uma foto do bolo pronto. "Quero uma lista de frutas em Python. Exemplo:
frutas = ['maçã', 'banana']". - Peça respostas curtas: Se você só precisa de uma linha de código, diga! "Me dê apenas a função, sem explicações adicionais". Isso evita que a IA gere parágrafos de texto desnecessários.
- Use o histórico a seu favor: A IA lembra da conversa recente. Você pode dizer "usando a mesma lógica do exemplo anterior, faça agora para produtos". Isso é como continuar um assunto sem ter que repetir tudo desde o começo.
Lembre-se: Tudo o que está na janela da conversa – suas perguntas, o histórico, arquivos que você enviou – consome tokens. Quanto mais coisas ali, mais tokens são usados só para a IA "ler" o contexto.
Dicas práticas para economizar tokens no dia a dia
Vamos a truques simples que você pode usar agora:
- Limpe o histórico: Se a conversa está muito longa e já mudou de assunto, considere começar uma nova. Isso "zera" o contexto e libera tokens.
- Comente seu código: Escreva comentários claros no seu próprio código (usando
//ou#). Quando o Copilot ler seu arquivo, ele entenderá melhor sua intenção com menos tokens de contexto. - Divida tarefas grandes: Em vez de pedir "crie um site de e-commerce completo", peça por partes: "1. Crie o cabeçalho com logo e menu. 2. Agora, faça a listagem de produtos". É mais fácil para a IA e para você controlar.
- Reutilize prompts: Se você descobrir uma forma de pedir algo que funciona muito bem (um prompt), salve essa frase! Use-a de novo no futuro. Um prompt é simplesmente a instrução ou pergunta que você faz para a IA.
Aqui está uma comparação de abordagens:
| Como Pedir (Prompt) | Resultado Provável | Consumo de Tokens |
|---|---|---|
| "Me ajude com um código" | Resposta genérica, longa, talvez não útil | ALTO - A IA tenta adivinhar tudo. |
| "Escreva uma função em Python que some dois números" | Código direto, provavelmente correto. | BAIXO - A IA entende a tarefa exata. |
| "Explique como uma API REST funciona, com analogias simples" | Explicação textual longa. | MÉDIO/ALTO - Geração de muito texto. |
| "Dê o código JSON de exemplo para uma API REST" | Bloco de código compacto. | BAIXO - Geração focada em código. |
Erros comuns que desperdiçam seus tokens
Fique de olho nesses hábitos que fazem seus tokens sumirem rápido:
- Conversar em vez de programar: Ficar batendo papo com a IA sobre o problema, em vez de pedir o código diretamente, enche o histórico com texto.
- Enviar arquivos enormes sem necessidade: Se você enviar um arquivo de 1000 linhas para a IA analisar, isso consome muitos tokens de uma vez. Envie apenas as partes relevantes.
- Não revisar o código gerado: Às vezes, a IA sugere um método muito complicado. Você aceita e depois pede para simplificar, gerando uma nova troca de tokens. Revise primeiro se o código faz sentido.
- Ignorar mensagens de erro claras: Antes de perguntar para a IA, leia a mensagem de erro no seu programa. Muitas vezes a solução está lá, e você economiza uma consulta.
- Pedir explicações longas sempre: Para um iniciante, explicações são ótimas! Mas conforme você aprende, tente pedir só o código. Você pode buscar a explicação separadamente, se precisar, como neste guia sobre Como economizar tokens no Claude (guia completo).
Recomendamos testar estas 3 skills primeiro
No ecossistema Claude, existem Skills, que são como "aplicativos" ou "funções extras" que você pode adicionar à IA para ela fazer tarefas específicas melhor. Para um leigo, pense como instalar um novo filtro no seu app de foto: ele dá uma habilidade nova à ferramenta. Aqui estão três skills úteis para gerenciar tokens:
- token-budget-advisor-affaan-m: Esta skill age como um consultor de gastos. Ela ajuda você a monitorar quantos tokens está usando em uma conversa, dando dicas para não passar do seu "orçamento".
- context-budget-affaan-m: O foco aqui é o "contexto", que é toda a história da conversa. Essa skill ajuda a gerenciar o que fica na memória da IA, sugerindo o que pode ser resumido ou removido para economizar tokens.
- strategic-compact-affaan-m: Esta skill é sobre ser estratégico e compacto. Ela reescreve seus comandos para a IA, tornando-os mais claros e curtos, o que pode resultar em respostas mais diretas e com menos gasto de tokens.
Você pode encontrar mais skills úteis no repositório oficial ou buscando skills para suas necessidades.
Perguntas frequentes
Tokens são a mesma coisa que caracteres? Não exatamente. Um token pode ser uma palavra curta, uma sílaba, um caractere especial ou até parte de uma palavra. Em português, 1 milhão de tokens equivale a aproximadamente 555 mil palavras.
Economizar tokens torna a resposta da IA pior? Pelo contrário! Instruções claras e diretas normalmente levam a respostas mais precisas e úteis. A IA gasta menos energia tentando adivinhar o que você quer e mais energia fazendo a coisa certa.
Posso reutilizar tokens que já gastei? Não. Tokens são o combustível consumido naquela conversa específica. Eles não são recarregados ou reutilizados. Seu plano tem um limite (diário, semanal) que se renova com o tempo.
Codex e Copilot são gratuitos? Depende. Algumas ferramentas, como o GitHub Copilot, têm planos pagos. O Claude Code, por exemplo, está incluído em planos pagos do Claude. Para detalhes exatos de preços e limites, como os Limites do Claude por plano (Free, Pro, Max), sempre confira na página oficial.
O que é MCP e ele ajuda a economizar tokens? MCP (Model Context Protocol) é um padrão para conectar a IA a outras ferramentas (como seu calendário ou planilha). Pense como uma porta USB-C universal. Ele pode ajudar indiretamente, pois permite que a IA acesse dados de forma estruturada, sem você ter que colar montes de texto manualmente. Entenda melhor em O que é MCP (Model Context Protocol): explicado de um jeito fácil.
Leia também
- Para dicas específicas de código, veja Economizar tokens no Claude Code: 12 truques.
- Quer saber mais sobre o Claude Code? Claude Code: o que é, como baixar, instalar e quanto custa (guia 2026).
- Entenda o conceito por trás dos assistentes automáticos: Agente de IA: o que é, como funciona e como criar o seu (sem programar).
Fontes
- Anthropic: janelas de contexto (consultado em 16/10/2026)
- Anthropic: contagem de tokens (consultado em 16/10/2026)
- Planos e preços do Claude (consultado em 16/10/2026)
Guia completo do tema: O que são tokens em IA (e por que eles acabam tão rápido)