O que são tokens em IA (e por que eles acabam tão rápido)
Equipe Skillpedia · atualizado em 16/10/2026 · 14 min de leitura
Resposta curta: Tokens são os pedaços de texto que uma IA lê e escreve. Eles funcionam como unidade de medida da memória e do custo. Quando um limite acaba rápido, normalmente não é só pelo tamanho da sua pergunta, mas por tudo que entra ali: histórico, arquivos, ferramentas e respostas.
Se você já viu o aviso de que o limite do Claude acabou e ficou sem entender o motivo, este post é para você. Vamos explicar o que são tokens em IA em linguagem simples. Vou usar exemplos do dia a dia. Nada de jargão solto no ar. Quando aparecer um termo técnico, eu explico. A ideia é te ajudar a entender por que conversas longas, arquivos pesados e agentes de IA gastam tokens em silêncio.
Índice
- O que é um token, na prática
- Como uma frase vira tokens?
- Quanto vale um token?
- Por que o português usa mais tokens?
- A janela de contexto é uma mesa de trabalho
- O que conta como token?
- Tokens de entrada, tokens de saída e preço
- Por que o limite do Claude acaba tão rápido?
- 10 dicas para economizar tokens
- Recomendamos testar estas 3 skills primeiro
- Perguntas frequentes
O que é um token, na prática
Token é um pedaço de texto. Pode ser uma palavra. Pode ser uma parte de palavra. Pode ser sinal de pontuação. Pode ser um espaço. Pode ser uma letra. Depende de como o sistema divide o texto.
Em IA, token é a unidade básica de leitura e escrita. A IA não entende “frases” exatamente como a gente entende. Ela transforma seu texto em tokens, faz o cálculo e devolve novos tokens como resposta.
Pense assim: cada parágrafo vira uma sequência de peças pequenas. Essas peças são os tokens. Quanto mais peças você usa, mais “espaço” e mais “custo” a tarefa ocupa.
Para o usuário comum, isso importa por dois motivos:
- Custo: muitos planos e APIs cobram por token usado.
- Memória: conversas e arquivos precisam caber na janela de contexto.
Entender o que são tokens em IA ajuda a evitar avisos de limite, respostas curtas demais ou conversas que “esquecem” coisas importantes.
Como uma frase vira tokens?
Vamos ver um exemplo visual. Suponha esta frase:
“O café está quente e eu quero ler o livro.”
Uma possível divisão ilustrativa seria:
O | café | está | quente | e | eu | quero | ler | o | livro | .
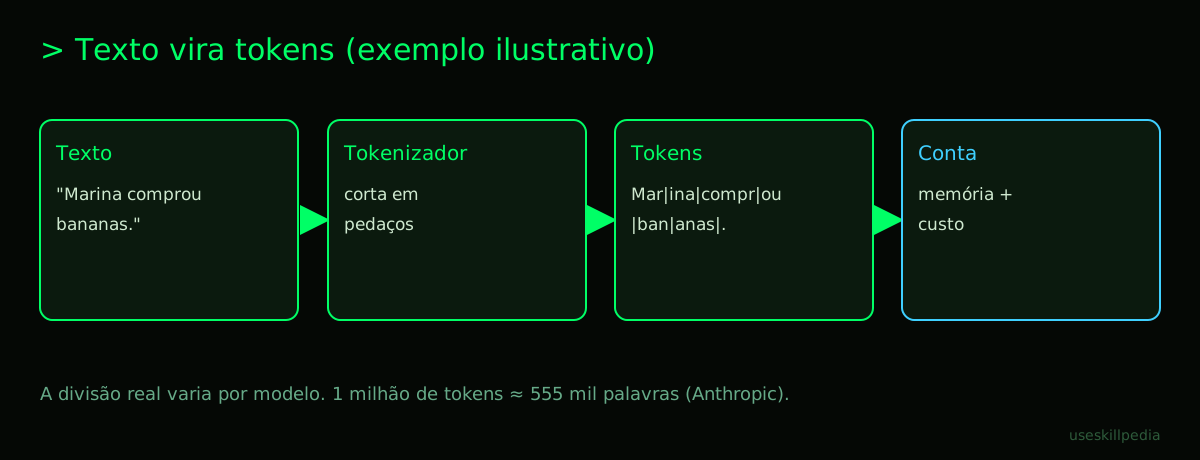
Nesta frase, cada pedaço aparece como um token. Mas atenção: a divisão real muda. Cada sistema usa um tokenizador próprio. Um mesmo texto pode virar uma quantidade diferente de tokens dependendo da IA, da versão e até do formato do conteúdo.
Agora veja uma frase com nome e pontuação:
“Marina foi ao mercado e comprou: bananas, café e pão.”
Uma divisão ilustrativa poderia ser:
Mar | ina | foi | ao | mercado | e | comprou | : | ban | anas | , | café | e | pão | .
Alguns nomes podem ser quebrados. Palavras com acento podem virar mais peças. Espaços e pontuações também contam.
Quanto vale um token?
Um número útil para dar perspectiva: 1 milhão de tokens equivale a cerca de 555 mil palavras no tokenizador atual da Anthropic. Também dá para dizer que são aproximadamente 2,5 milhões de caracteres.
Isso parece muito. E é. Mas nem sempre 555 mil palavras cabem em uma conversa simples. O motivo é que o sistema pode precisar levar muitas outras informações junto com a sua pergunta.
Aqui entra um detalhe importante: o tokenizador atual da Anthropic foi introduzido no Claude Opus 4.7. Ele gera cerca de 30% mais tokens para o mesmo texto que os modelos anteriores. Ou seja, um texto que antes gastava X agora pode gastar mais. Não porque o texto mudou. O sistema que divide em tokens ficou diferente.
Isso também explica por que uma tarefa pode custar mais do que parece. Você vê “um parágrafo”. O modelo vê “uma pilha de peças”.
Por que o português usa mais tokens?
Em geral, o português costuma gastar mais tokens que o inglês. Não vou cravar um número aqui, porque isso depende do texto e do sistema. Mas o padrão existe.
Motivos comuns:
- palavras com acento, como “café”, “pão” e “não”;
- nomes próprios brasileiros ou estrangeiros;
- terminações de verbo e plural;
- pontuação no meio de frases;
Se você escreve em português, pode ser que o mesmo texto ocupe mais espaço do que um texto equivalente em inglês. Isso não é regra exata, mas é um comportamento comum. Para quem usa IA todo dia, vale lembrar: economizar palavras ajuda, mas economizar contexto ajuda mais.
A janela de contexto é uma mesa de trabalho
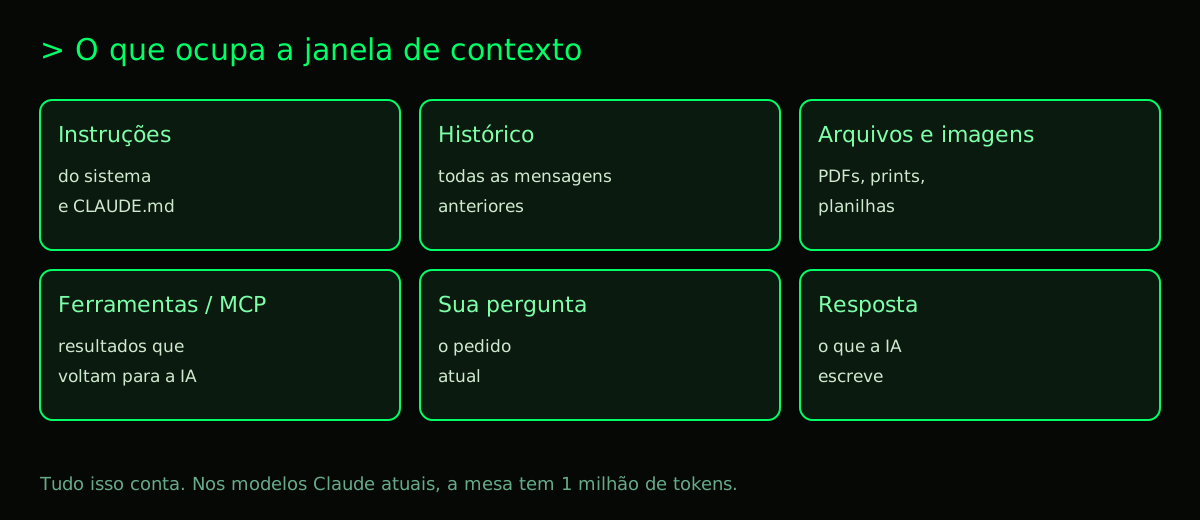
Janela de contexto é o espaço que a IA usa para lembrar da conversa. É como uma mesa de trabalho. Nela cabem documentos abertos, cadernos, ferramentas, notas e a resposta sendo escrita.
Se a mesa é pequena, ela lota rápido. Se a mesa é grande, ainda pode lotar se você espalhar muitos arquivos, prints, PDFs, logs, planilhas e respostas longas.
Nos modelos Claude citados, a janela de contexto é de 1 milhão de tokens. A saída máxima é de 128 mil tokens. Na prática, isso é bem grande. Mas a mesa não é infinita. Ela precisa dividir espaço com tudo que você manda, tudo que o sistema lembra e tudo que o modelo precisa escrever.
Para entender melhor o papel da janela, veja Agente de IA: o que é, como funciona e como criar o seu (sem programar). Agentes costumam usar contexto maior, porque precisam de metas, ferramentas e decisões em várias etapas.
O que conta como token?
Aqui está a parte que muita gente esquece. O token não é só o que você digita no chat. Tudo entra na conta.
Contam como token:
- Instruções do sistema: regras internas que o app usa para responder.
- Histórico da conversa: mensagens anteriores.
- Arquivos enviados: documentos, planilhas, textos copiados.
- Imagens: fotos, prints e diagramas.
- Resultados de ferramentas: respostas de busca, planilhas, banco de dados, API.
- Resposta gerada: o texto que a IA escreve.
- Configurações e memória: quando o sistema leva informações adicionais.
Se você usa MCP, isso pode aumentar bastante. MCP, ou Model Context Protocol, é um padrão aberto para conectar IA a dados, ferramentas e fluxos externos. A analogia oficial fala em “uma porta USB-C para aplicativos de IA”. Você pode entender mais em O que é MCP (Model Context Protocol): explicado de um jeito fácil.
Para o leigo, pense assim: cada ferramenta conectada abre uma gaveta extra na mesa. Se a gaveta estiver cheia, ela consome espaço.
Tokens de entrada, tokens de saída e preço
Existem dois lados da conta: entrada e saída.
Tokens de entrada são tudo o que você e o sistema enviam para a IA analisar. Exemplo: sua pergunta, o histórico, o arquivo colado.
Tokens de saída são o que a IA responde. Uma resposta longa gasta mais tokens de saída. Em muitos planos e APIs, saída costuma custar mais caro que entrada.
A tabela abaixo compara alguns modelos atuais com base nos números informados. Preços são por 1 milhão de tokens.
| Modelo | Entrada por 1M tokens | Saída por 1M tokens | Uso simples |
|---|---|---|---|
| Claude Haiku 5.5 | a partir de US$ 0,10 | a partir de US$ 0,50 | Rápido e barato. Acima de 100 mil tokens no prompt, pode ficar mais caro. |
| Claude Sonnet 5.5 | US$ 2 | US$ 10 | Bom equilíbrio. Lidera o teste de código Vibe Code Bench (Vals.ai, out/2026). |
| Claude Opus 5.5 | US$ 4 | US$ 20 | Alto nível. Lidera o Artificial Analysis Intelligence Index com 57,6 em out/2026. |
| Claude Fable 5.1 | US$ 10 | US$ 50 | Mais avançado, para agentes longos. |
| GPT-6 Luna | US$ 0,10 | US$ 0,50 | Barato e rápido. Disponível para usuários Free e Go no app desktop. |
| GPT-6.1 Sol | US$ 2 | US$ 10 | Quase o nível do Astra por 1/5 do preço. Lidera matemática no ranking citado. |
| GPT-6 Astra | US$ 10 | US$ 50 | Modelo topo. |
Também existem outros modelos, como Meta Muse Wonder, xAI Grok 4.7, Mistral Large 4 em preview e DeepSeek V4.1 Flash. E o Google tem o Gemini 4 Argon, disponível globalmente desde 13/10/2026 na API e no app Gemini para assinantes Google AI Pro e Ultra, além do AI Mode da Busca. Segundo o Google, ele aparece em 1º no Vals Index. Para escolher qual usar, veja Melhores modelos de IA em 2026: qual usar para cada tarefa.
Por que o limite do Claude acaba tão rápido?
Aqui está a frustração comum: você conversa pouco, mas o plano acaba rápido. Isso acontece porque limite de uso não é medido só pela sua pergunta. É medido pelo contexto inteiro da conversa.
Os motivos principais:
1. Conversas longas reenviam o histórico
Cada nova mensagem pode levar novamente o histórico anterior. Se você fez dez perguntas grandes, a décima pode carregar as dez anteriores dentro da conta de tokens. Quanto mais longa a conversa, mais “pesada” ela fica.
2. Arquivos grandes e copiar/colar pesa
Um PDF, um log, uma planilha ou um texto colado ocupam espaço. Mesmo que a IA resuma depois, tudo entra na mesa primeiro.
3. MCPs e ferramentas gastam tokens
Ferramentas externas podem consultar bancos de dados, arquivos, agenda, CRM ou APIs. Cada resultado volta como texto. Se o resultado é grande, a conta sobe. Se você usa várias ferramentas, elas somam.
4. Os modelos novos da Anthropic contam mais tokens
O tokenizador atual da Anthropic gera cerca de 30% mais tokens para o mesmo texto que modelos anteriores. Isso não é “erro”. É como o texto passa a ser medido.
5. A janela de renovação é de 5 horas
Nos planos Claude, os limites de uso renovam numa janela de 5 horas. O Free custa US$ 0. O Pro custa US$ 20/mês no plano mensal ou US$ 17/mês no anual, com US$ 200 cobrados de uma vez. O Max começa em US$ 100/mês, com opções Max 5x por US$ 100 e Max 20x por US$ 200. Max dá 5x ou 20x o uso do Pro por sessão de 5 horas. Planos pagos também têm limite semanal.
E há um detalhe importante: Claude Code e chat dividem o mesmo limite. Então programar com o Claude Code pode consumir o mesmo orçamento que a conversa no Claude. Se isso é seu caso, leia Claude Code: o que é, como baixar, instalar e quanto custa (guia 2026) e Limites do Claude por plano.
Também vale lembrar: Skills e Conectores existem em todos os planos, inclusive Free. Claude Code está incluso em todos os planos pagos, mas não no Free.
Para entender melhor como economizar dentro do mesmo plano, veja Como economizar tokens no Claude.
10 dicas para economizar tokens
Aqui vai um roteiro simples. Você não precisa fazer tudo. Escolha três dicas e comece por elas.
1. Abra uma nova conversa por tarefa
Conversa longa acumula histórico. Se a tarefa mudou, comece nova. Assim, o modelo não carrega tudo o que foi dito antes sem necessidade.
2. Peça um resumo antes de continuar
Em vez de manter 50 mensagens grandes, peça algo como:
“Resuma o que decidimos até aqui em até 100 palavras. Depois, continue só com isso.”
Isso ajuda a limpar a mesa. Depois, colar o resumo em uma nova conversa costuma ser mais barato.
3. Use modelo menor para tarefas simples
Não precisa usar o modelo mais forte para tudo. Para revisar texto curto, listar ideias ou explicar um termo simples, um modelo mais barato pode ser suficiente. Para tarefas longas e complexas, aí sim vale um modelo mais avançado.
4. Use skills em vez de colar instruções toda hora
Skill é uma pasta com instruções, scripts e referências. Ela pode carregar só o nome e a descrição primeiro. Só quando a tarefa precisa é que ela abre mais detalhes. Isso poupa contexto.
Se você usa Claude Code, isso é muito útil. Para entender melhor, leia Skill Claude: o que é, como instalar e as melhores para testar (guia 2026).
5. desligue mCPs que você não usa
Cada ferramenta conectada pode trazer instruções, opções e resultados. Se não está usando, desligue. Menos gaveta aberta significa menos coisa ocupando a mesa.
6. Peça respostas curtas
Você pode ser direto:
“Responda em 3 bullets.”
Ou:
“Explique como se fosse para alguém iniciante, com no máximo 80 palavras.”
Isso reduz tokens de saída. Como saída costuma ser mais cara, ajuda muito.
7. Mantenha o CLAUDE.md enxuto
Se você usa Claude Code, o CLAUDE.md pode conter instruções do projeto. Isso é ótimo para não repetir ordens. Mas não coloque tudo lá. Mantenha só o essencial: stack, comandos principais, regras de estilo e pontos de atenção.
Se o arquivo virar um livro, ele vai ocupando contexto em quase toda tarefa.
8. Use /compact e /clear no Claude Code
No Claude Code, /compact ajuda a resumir a conversa atual. /clear limpa o contexto. Use /compact quando a conversa estiver longa. Use /clear quando iniciar uma nova tarefa.
9. Não cole arquivos inteiros se você precisa só de uma parte
Se o problema está em um trecho, cole só o trecho. Se é um PDF, mande a página necessária. Se é um log, filtre primeiro. Menos texto entra, menos tokens são gastos.
10. Compare modelos antes de trocar de ferramenta
Nem sempre a IA que responde mais bonito é a que cabe no seu uso. Para programar, uma IA pode ser melhor. Para escrever, outra pode custar menos. Para agentes longos, talvez você precise de um modelo mais caro, mas com menos turnos. Veja também Economizar tokens no Claude Code: 12 truques e Economizar tokens no Codex e Copilot.
Recomendamos testar estas 3 skills primeiro
Skills podem ajudar a lidar com tokens de forma mais organizada. Aqui estão três para testar primeiro.
- token-budget-advisor-affaan-m: ajuda a entender quanto uma tarefa pode gastar de tokens e como ajustar o pedido para economizar sem estragar a resposta.
- context-budget-affaan-m: organiza o que precisa entrar na conversa e o que pode ser resumido, evitando que arquivos e instruções ocupem espaço demais.
- strategic-compact-affaan-m: indica o melhor momento para compactar ou resumir a conversa, guardando o que importa e descartando o que não ajuda mais.
Se você quiser explorar mais opções, dá para buscar skills.
Perguntas frequentes
1. Token é a mesma coisa que palavra?
Não. Palavra costuma virar uma ou mais tokens. Sinais, espaços e partes de palavras também contam.
2. Por que minha conversa com IA “esquece” coisas antigas?
Pode ser que o contexto tenha lotado. A mesa de trabalho enche. O sistema passa a dar mais atenção às partes mais recentes ou úteis.
3. Arquivo grande sempre gasta mais?
Sim. Arquivo grande pode ocupar muitos tokens. Se você precisa só de um trecho, use um trecho.
4. Resposta longa é mais cara que pergunta longa?
Em geral, a saída é mais cara que a entrada. Então pedir respostas curtas ajuda bastante.
5. MCPs gastam tokens mesmo se eu não uso?
Podem gastar. Ferramentas conectadas podem trazer instruções e opções para a mesa. Desligue o que você não precisa.
6. O limite de 5 horas vale para chat e Claude Code?
No Claude, chat e Claude Code dividem o mesmo limite. A janela de renovação é de 5 horas.
7. Skills ajudam a economizar?
Elas podem ajudar. Em vez de colar instruções grandes toda hora, você usa uma skill com carregamento progressivo.
Leia também
- Como economizar tokens no Claude
- Economizar tokens no Claude Code: 12 truques
- Limites do Claude por plano
- O que é MCP (Model Context Protocol): explicado de um jeito fácil
- Claude Code: o que é, como baixar, instalar e quanto custa (guia 2026)
- Skill Claude: o que é, como instalar e as melhores para testar (guia 2026)
Fontes
- Anthropic: visão geral dos modelos (contexto e tokens) (consultado em 16/10/2026)
- Anthropic: contagem de tokens (consultado em 16/10/2026)
- Anthropic: janelas de contexto (consultado em 16/10/2026)
- Modelos da OpenAI (consultado em 16/10/2026)
- Planos e preços do Claude (consultado em 16/10/2026)
- Preços da API da Anthropic (consultado em 16/10/2026)